均分相同,也可能有差异
一致性以逐项评分为准,避免不同维度的变化在平均后互相抵消。

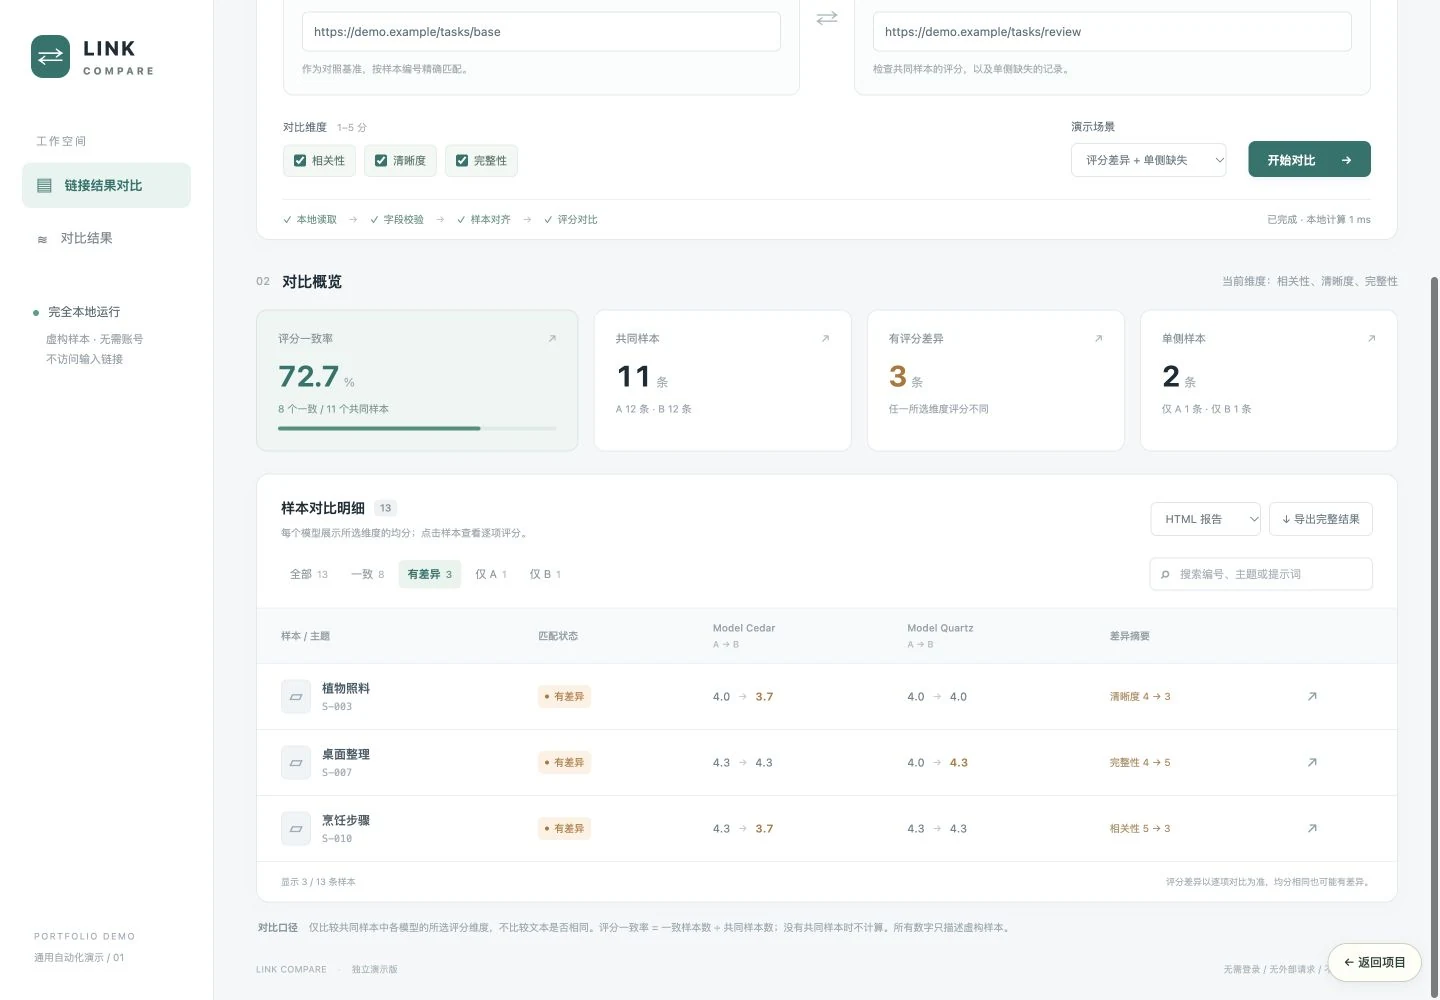
当两份结果里的样本和评分不完全一致,逐条查找很容易遗漏。我把对齐、校验、比较与导出,整理成一个可以反复检查的流程。
 RESULT COMPARISON / FICTIONAL DATA DEMO
两份记录看起来相似,真正需要关注的却可能藏在某一个模型、某一个评分维度里。只比较均分,容易掩盖逐项差异;只看共同样本,又会忽略单侧缺失。
我将编号对齐、逐项核验和缺失检查整理成可重复使用的对比流程,让问题有据可查。
检查样本编号、重复记录、模型结果和评分范围。
把共同样本放在一起,单独保留仅 A、仅 B 的记录。
在选定维度中逐项比较模型评分,保留差异来源。
查看有差异的样本,导出完整 HTML、CSV 或 JSON。
无需账号,使用虚构样例。
从一次操作,看见规则怎样影响结果。
链接只映射本地虚构数据,不读取真实链接,也不调用模型服务。演示展示文本与评分对比,不代表模型真实性能。
一致性以逐项评分为准,避免不同维度的变化在平均后互相抵消。
单侧记录独立展示,不放入共同样本的一致率分母。
重复编号、无效评分等问题会阻止对比,避免错误输入生成看似可信的结果。